Ein LLM lokal zu betreiben bedeutet, ein Sprachmodell direkt auf dem eigenen Computer laufen zu lassen, ohne jede Anfrage an einen Cloud-Dienst schicken zu müssen. Modelle wie Llama oder Mistral lassen sich auch auf einem Mini PC ausführen – die Konfiguration spielt dabei aber eine große Rolle. Welche Modelle sich nutzen lassen und wie flüssig sie laufen, hängt von mehreren Komponenten ab: RAM und Speicherbandbreite, CPU, GPU, Speicherplatz und Kühlung.
Warum ein LLM lokal betreiben?
Einer der wichtigsten Gründe ist der Datenschutz. Läuft das Modell direkt auf dem Rechner, können Prompts, Dokumente und andere Daten auf dem Gerät bleiben, statt an externe Server gesendet zu werden. Gerade wenn du mit Code, internen Unternehmensdokumenten oder Informationen arbeitest, die besser nicht online geteilt werden, ist das ein echter Vorteil.
Ein weiterer Pluspunkt ist die Offline-Nutzung – ohne verpflichtendes Abo für jede einzelne Anfrage. Sind Modell und Software einmal heruntergeladen, lassen sich viele Aufgaben auch ohne aktive Internetverbindung erledigen.
So kannst du frei wählen, welches Modell du nutzt, welche Quantisierung du einsetzt und welche Anwendungen du anbindest – ganz ohne Abonnement. Das gibt dir mehr Kontrolle über deine Daten und über die gesamte Umgebung.
Wer ernsthaft mit einem lokalen LLM experimentieren möchte, findet in dieser Freiheit einen der Hauptgründe, zumindest einen Teil der eigenen KI-Workflows auf das Gerät zu verlagern.
Was du brauchst, um ein LLM lokal auszuführen
Nicht jedes LLM benötigt dieselbe Hardware. Die nötigen Ressourcen hängen vor allem von der Größe des Modells und vom Grad der Quantisierung ab.
Indem du die Präzision reduzierst, mit der die Gewichte des Modells dargestellt werden, senkst du den Speicherbedarf und kannst auch vergleichsweise große Modelle auf kompakten Systemen nutzen.
Ein Modell mit 3 oder 4 Milliarden Parametern ist damit deutlich anspruchsloser als eines mit 30B oder mehr. Es braucht viel weniger Speicher, während der Qualitätsverlust in der Regel überschaubar bleibt. Je nach Modell und Quantisierung ändert sich die erforderliche Konfiguration.
Wie viel RAM braucht ein LLM?
Der erste Wert, auf den du bei der Wahl eines PCs für KI achten solltest, ist der RAM. Denn das Modell ist nicht der einzige Faktor, der Speicher belegt. Damit die Ausführung reibungslos läuft, muss auch Platz für Betriebssystem, Runtime und den Cache bleiben, der während der Generierung genutzt wird.
Diese Angaben sind Richtwerte. Der tatsächliche Bedarf hängt von Quantisierung, Kontext und Software ab. Grundsätzlich gilt: Je mehr RAM zur Verfügung steht, desto größer und komplexer sind die Modelle, die sich lokal ausführen lassen.
Wenn du zwischen zwei Konfigurationen schwankst, hilft dir dieser Vergleich zwischen 16 und 32 GB RAM weiter.
GPU, NPU und KI-Beschleunigung
Eine GPU beschleunigt die Inferenz, weil sie sich besonders gut für die parallelen Berechnungen eignet, die Sprachmodelle nutzen. Eine dedizierte GPU generiert Antworten deutlich schneller als eine reine CPU-Lösung. Die Leistung hängt jedoch nicht allein von der Rechenleistung ab.
Entscheidend ist auch, wie schnell CPU oder GPU auf die Daten zugreifen können. Die Speicherbandbreite beeinflusst die Leistung ebenso stark – vor allem bei Systemen, in denen sich CPU und integrierte Grafik denselben Speicher teilen. Eine höhere Bandbreite überträgt Daten schneller und kann die Inferenz flüssiger und effizienter machen, insbesondere bei größeren Modellen.
Neben CPU und GPU finden sich in modernen AI-PCs auch NPUs – Einheiten, die bestimmte KI-Lasten besonders energieeffizient bewältigen. Ihre Rolle unterscheidet sich von der einer GPU: Eine starke NPU macht ein System nicht automatisch ideal für das lokale Ausführen von LLMs. Der tatsächliche Nutzen hängt vom eingesetzten Modell, vom Runtime und davon ab, ob die Software die NPU-Beschleunigung überhaupt nutzen kann.
Um die Rolle der Grafikkarte und die Unterschiede zu anderen Beschleunigern besser zu verstehen, kann die Anleitung dazu, wie eine GPU funktioniert, hilfreich sein.
Speicher und Kühlung
Mehrere LLMs lokal zu nutzen bedeutet, eine stetig wachsende Datenmenge verwalten zu müssen.
Die Modelldateien können viele Gigabyte belegen. Deshalb empfiehlt sich eine geräumige NVMe-SSD – vor allem, wenn du mehrere Quantisierungen, Datensätze oder Dokumente für RAG-Systeme aufbewahren möchtest.
Ein wichtiger Punkt, den du nicht vernachlässigen solltest, ist die Kühlung. Bei langen Sessions stehen CPU und GPU oft über längere Zeit unter Last und erreichen hohe Temperaturen. Ein effektives Kühlsystem hilft, Throttling zu begrenzen und die Leistung konstanter zu halten.
Warum sich ein Mini PC für lokale KI eignet
Ein Mini PC kann eine sehr gute Lösung sein, wenn du einen kompakten PC für KI suchst, der sich der lokalen Inferenz widmet, ohne den Platz eines klassischen Desktops zu beanspruchen.
Dank der geringen Abmessungen lässt er sich problemlos auf dem Schreibtisch oder in einer kleinen Arbeitsumgebung unterbringen. Je nach Konfiguration bietet er zudem einen vergleichsweise niedrigen Stromverbrauch und eine geringere Geräuschentwicklung als klobigere Workstations.
Ein Mini PC ist ein System, das rund um die Uhr laufen kann, um anderen Geräten im Netzwerk ein Modell, eine lokale API oder Automatisierungsdienste bereitzustellen.
Die Kompatibilität mit Windows und Linux erweitert die Vielseitigkeit und die Einsatzszenarien zusätzlich.
Welche kompakten Systeme sich für den Dauerbetrieb eignen, zeigt dir die Übersicht zu den besten Mini PCs für Home Server.
Die besten Mini PCs für lokale LLMs

Am besten für den Einstieg – GEEKOM IT12
Der GEEKOM IT12 ist eine gute Wahl, wenn du mit lokalen LLMs starten möchtest. Die Ausstattung mit Intel Core Ultra 5 125U, 16 GB RAM und einer 512-GB-SSD bietet eine solide Basis für kompaktere Modelle, wobei sich der RAM auf bis zu 64 GB erweitern lässt. Zudem unterstützt er Software wie Ollama und LM Studio.
Am besten für LLMs mit viel RAM – GEEKOM IT15
Der GEEKOM IT15 setzt vor allem auf Arbeitsspeicher, mit Konfigurationen bis zu 128 GB DDR5-RAM und einem Intel Core Ultra 9 285H. Er eignet sich für alle, die größere quantisierte Modelle nutzen oder mit umfangreicheren Kontexten arbeiten möchten – und dabei den Vorteil des kompakten Formats behalten wollen.

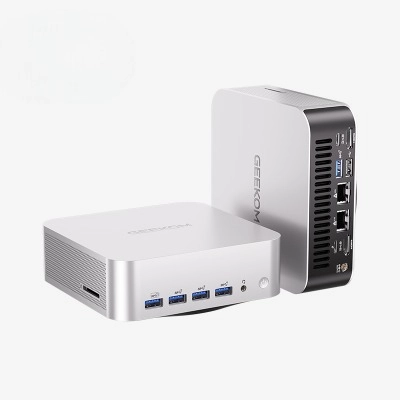
Am besten für anspruchsvolle lokale LLMs – GEEKOM A9 Mega
Der GEEKOM A9 Mega ist das am stärksten auf Local AI Computing ausgerichtete Modell. Mit Ryzen AI Max+ 388 und bis zu 64 GB LPDDR5X-Speicher bietet er reichlich Spielraum für die lokale Inferenz mit großen quantisierten Modellen. Er ist die passende Wahl für Entwickler und Nutzer, die mehr lokale KI-Leistung benötigen.
Am besten für KI-Produktivität – GEEKOM IT13 Max
Der GEEKOM IT13 Max ist darauf ausgelegt, KI in den Arbeitsalltag zu integrieren. Intel Core Ultra 9 185H, Intel-Arc-Grafik und eine dedizierte NPU machen ihn geeignet für Entwicklung, Content-Erstellung und professionelle Aufgaben. Eine ausgewogene Lösung für alle, die KI-Produktivität suchen, ohne ausschließlich auf die größten lokalen Modelle abzuzielen.

So gelingt der Einstieg: Software für lokale LLMs
Ein lokales LLM braucht nicht nur passende Hardware, sondern auch eine Software, mit der sich Modelle direkt auf dem eigenen Computer herunterladen, verwalten und starten lassen. Zu den verbreitetsten Lösungen gehören Ollama, LM Studio und GPT4All – Werkzeuge für unterschiedliche Anforderungen und Erfahrungsstufen.
Ollama ermöglicht es, Modelle direkt auf dem eigenen Computer herunterzuladen und auszuführen. Besonders praktisch ist das für alle, die vom Terminal aus arbeiten oder ein lokales LLM per API an andere Anwendungen anbinden möchten.
LM Studio setzt dagegen auf Einfachheit: Über eine grafische Oberfläche lassen sich Modelle wie Llama, Qwen, Gemma und weitere LLMs suchen, herunterladen und nutzen, ohne jede Komponente manuell konfigurieren zu müssen.
GPT4All ist eine weitere Alternative für alle, die lokale Modelle einfach und datenschutzfreundlich nutzen möchten. Die Funktion LocalDocs bindet Dokumente auf dem Computer ein und nutzt sie als Informationsquellen.
Um Open-Source-Betriebssysteme besser kennenzulernen, hilft dir die Anleitung zu Mini PCs mit Linux.
Häufig gestellte Fragen
Welchen RAM braucht man, um ein LLM lokal auszuführen?
Die nötige Menge hängt vor allem von der Modellgröße ab. Für vergleichsweise kleine Modelle, etwa mit 7 oder 8 Milliarden Parametern, können 16 GB RAM ausreichen, während dir 32 GB oder mehr größere Freiheit bei der Modellwahl geben. Für sehr große LLMs können hingegen 64 oder 128 GB Speicher nötig sein.
Kann ein Mini PC Modelle wie Llama oder Mistral ausführen?
Ja. Ein Mini PC kann LLMs wie Llama, Mistral, Qwen und andere Open-Source-Modelle ausführen, sofern er über ausreichend Speicher und Rechenleistung verfügt. Maximale Größe und Geschwindigkeit hängen vor allem von verfügbarem Speicher, Bandbreite und Hardwarebeschleunigung ab. Mit quantisierten Versionen lassen sich einige dieser Modelle auch auf recht kompakten Konfigurationen betreiben.
Braucht man eine dedizierte GPU für lokale KI?
Nicht zwingend. Viele LLMs lassen sich über die CPU oder eine integrierte GPU ausführen, auch wenn die Leistung geringer ausfallen kann als bei einer stärkeren GPU. Wichtig wird die GPU vor allem dann, wenn du größere Modelle nutzen oder schnellere Antworten erhalten möchtest.
Reichen „AI-PC“ und NPU aus, um ein LLM auszuführen?
Eine NPU kann die Effizienz bei bestimmten KI-Aufgaben verbessern, ist aber nicht der einzige entscheidende Faktor. Für LLMs zählen ebenso CPU, GPU, verfügbarer Speicher und die Kompatibilität der eingesetzten Software. Ein guter AI-PC sollte daher ein Gleichgewicht zwischen all diesen Komponenten bieten.
Was kostet ein Mini PC für lokale KI?
Der Preis variiert stark je nach geforderter Leistung. Ein Mini PC der Mittelklasse kann ausreichen, um mit kleineren LLMs zu experimentieren, während für fortgeschrittene Modelle Konfigurationen mit leistungsstärkeren Prozessoren und viel Speicher nötig sind – mit Preisen, die 1.000 Euro durchaus überschreiten können. Die Wahl sollte sich also vor allem an der Größe der Modelle orientieren, die du nutzen möchtest, sowie an der gewünschten Ausführungsgeschwindigkeit.
Welchen Mini PC sollte man für ein lokales LLM wählen?
Die Wahl eines Mini PCs für lokale LLMs hängt vor allem von der Menge des verfügbaren RAMs, der Leistung von CPU und GPU sowie von der Größe der Modelle ab, die du ausführen möchtest. Auch die Möglichkeit, Speicher und Arbeitsspeicher zu erweitern, kann den Unterschied machen – besonders, wenn du planst, mit der Zeit anspruchsvollere Modelle zu nutzen. Wichtig sind zudem Stromverbrauch, Kühlung und die Kompatibilität mit der Software für lokale KI. Um die verschiedenen Konfigurationen zu vergleichen, kannst du dir die kompakten Systeme für lokale KI ansehen.