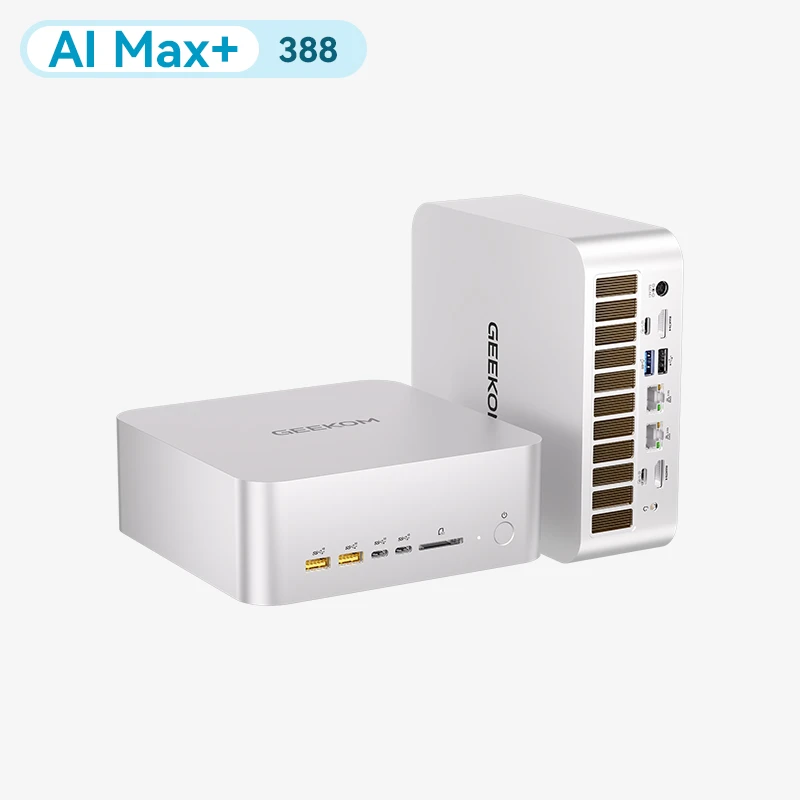
Diese Anleitung richtet sich an Nutzer, die mit dem Linux-Terminal vertraut sind und mehr wollen als eine Chat-Oberfläche: Wir kompilieren llama.cpp selbst, aktivieren Multi-Token-Prediction (MTP) für schnellere Antworten, nutzen die vollen 256K Kontext und betreiben Qwen3.8 Flash Next als dauerhaften systemd-Dienst mit OpenAI-kompatibler API.
Wer einen einfacheren Einstieg sucht, findet in unserer Anleitung gpt-oss-120b lokal installieren den Weg über LM Studio unter Windows.
http://localhost:8080/v1,
Autostart beim Booten, automatischer Neustart bei Fehlern
Das Ergebnis im Test
Auf unserem Testsystem hat diese Konfiguration folgende Werte erreicht:
| Messwert | Ergebnis |
|---|---|
| Generierung (intern, llama-server) | ca. 31–33 Token/s |
| End-to-End über HTTP-API | ca. 26–36 Token/s |
| Speicherbelegung | ca. 110 GB |
| Maximaler Kontext | 262.144 Token (256K) |
Qwen3.8 Flash Next kurz erklärt
Qwen3.8 Flash Next ist ein offenes, multimodales Mixture-of-Experts-Modell mit rund 125 Milliarden Parametern und einem Kontextfenster von 262K Token (Unsloth). Für 128-GB-Systeme ist die Quantisierung UD-IQ4_XS mit 93,7 GB der sinnvollste Kompromiss aus Qualität und Speicherbedarf.
MTP (Multi-Token-Prediction) ist eine Form des spekulativen Decodings: Ein kleines Draft-Modell schlägt mehrere Token im Voraus vor, das Hauptmodell prüft sie in einem Durchgang. Werden die Vorschläge akzeptiert, steigt die Ausgabegeschwindigkeit, ohne dass sich das Ergebnis ändert.
Schritt 1: Kernel für großen GPU-Speicher vorbereiten
Unter Linux teilt der Kernel der integrierten Grafik standardmäßig nur einen Teil des Arbeitsspeichers als GTT-Speicher zu. Für ein 94-GB-Modell reicht das nicht. Dieser Schritt fehlt in vielen Anleitungen und ist die häufigste Ursache für Abbrüche beim Laden.
BIOS: Stelle die UMA Frame Buffer Size auf Auto oder den kleinsten Wert (512 MB). Ein fest reservierter Grafikspeicher im BIOS wäre für Linux dauerhaft blockiert. Den Speicher teilen wir stattdessen dynamisch über den Kernel zu.
Kernel-Parameter setzen:
sudo nano /etc/default/grubErgänze die Zeile GRUB_CMDLINE_LINUX_DEFAULT so:
GRUB_CMDLINE_LINUX_DEFAULT="quiet splash ttm.pages_limit=31457280 amdgpu.gttsize=120000"sudo update-grub
sudo rebootttm.pages_limit=31457280 entspricht 120 GB (31.457.280 Seiten à 4 KB). So bleiben rund 8 GB für das Betriebssystem (Zypher Systems).
Prüfen:
sudo dmesg | grep -i "gtt memory"Schritt 2: Pakete installieren und Vulkan prüfen
sudo apt update
sudo apt install -y git curl aria2 cmake ninja-build build-essential \
  vulkan-tools libvulkan-dev glslc
vulkaninfo --summary | grep -i devicenameSchritt 3: Modell-Laufwerk fest einbinden
Das Originalsetup nutzt den automatischen Mount-Pfad des Desktops (/run/media/…). Das hat einen Haken: Der Desktop hängt Laufwerke erst nach der Anmeldung ein. Startet der Dienst beim Booten vorher, findet er das Modell nicht. Deshalb binden wir das Laufwerk fest per /etc/fstab ein.
lsblk -fNotiere die UUID der Partition und lege den Mount-Punkt an:
sudo mkdir -p /mnt/modelsTrage das Laufwerk in /etc/fstab ein. Für eine ext4-Partition (empfohlen):
UUID=DEINE-UUID /mnt/models ext4 defaults,nofail 0 2Für eine NTFS-Partition (z. B. eine bestehende Windows-Datenplatte):
UUID=DEINE-UUID /mnt/models ntfs3 uid=1000,gid=1000,nofail 0 0UUID=DEINE-UUID /mnt/models ntfs3 uid=1000,gid=1000,nofail 0 0sudo systemctl daemon-reload
sudo mount -a
sudo chown "$USER:$USER" /mnt/models # nur bei ext4 nötigAb hier arbeiten wir mit Variablen statt fester Pfade. So musst du Benutzernamen und Laufwerk nur an einer Stelle anpassen:
export MODEL_ROOT=/mnt/models
export QWEN_DIR="$MODEL_ROOT/Qwen3.8-Flash-Next-GGUF"
export LLAMA_DIR="$HOME/llama.cpp"
Schritt 4: Modell und MTP-Draft herunterladen
mkdir -p "$QWEN_DIR/UD-IQ4_XS" "$QWEN_DIR/MTP"

BASE=https://huggingface.co/unsloth/Qwen3.8-Flash-Next-GGUF/resolve/main

# Hauptmodell: alle drei Teile sind erforderlich
for i in 1 2 3; do
  aria2c -x8 -s8 -c -d "$QWEN_DIR/UD-IQ4_XS" \
    "$BASE/UD-IQ4_XS/Qwen3.8-Flash-Next-UD-IQ4_XS-0000${i}-of-00003.gguf"
done

# MTP-Draft-Modell
aria2c -x8 -s8 -c -d "$QWEN_DIR/MTP" \
  "$BASE/MTP/mtp-Qwen3.8-Flash-Next-shared-Q8_0.gguf"
-c setzt abgebrochene Downloads fort, -x8 -s8 lädt über acht parallele Verbindungen. Bei 100 Mbit/s dauert der Download rund 2 Stunden, bei 1 Gbit/s etwa 15 Minuten.
ls -lh "$QWEN_DIR"/UD-IQ4_XS "$QWEN_DIR"/MTP.aria2-Restdateien.
Das Hauptmodell ist zusammen rund 94 GB groß
(Hugging Face).
Schritt 5: llama.cpp mit MTP-Patch kompilieren
git clone https://github.com/ggml-org/llama.cpp.git "$LLAMA_DIR"
cd "$LLAMA_DIR"
git rev-parse --short HEAD  # Commit notieren, falls du später reproduzieren willst
MTP-Unterstützung für Qwen3.8 Flash Next ist zum Zeitpunkt des Tests noch nicht im Hauptzweig von llama.cpp enthalten. Sie kommt über Pull Request #28243:
curl -L "https://github.com/ggml-org/llama.cpp/pull/28243.diff" -o /tmp/pr-28243.diff
git apply --check /tmp/pr-28243.diff && git apply /tmp/pr-28243.diffgit apply --check „patch failed“ oder „does not apply“, brich hier ab.
Entweder wurde der PR inzwischen gemergt (dann ist kein Patch mehr nötig) oder der Code hat sich geändert.
Prüfe den Status von PR #28243, bevor du weitermachst. Der PR ist noch in Arbeit, Parameter und Verhalten können sich ändern.
Vulkan-Build:
cmake -B build-vulkan-mtp -S . -G Ninja \
  -DCMAKE_BUILD_TYPE=Release \
  -DGGML_VULKAN=ON \
  -DGGML_NATIVE=OFF \
  -DGGML_OPENMP=ON \
  -DGGML_LTO=ON \
  -DBUILD_SHARED_LIBS=OFF

cmake --build build-vulkan-mtp --config Release --target llama-server -j"$(nproc)"$LLAMA_DIR/build-vulkan-mtp/bin/llama-server existiert und
./build-vulkan-mtp/bin/llama-server --help | grep -i draft-mtp
liefert einen Treffer.
Schritt 6: Erster Start im Terminal
"$LLAMA_DIR/build-vulkan-mtp/bin/llama-server" \
  -m "$QWEN_DIR/UD-IQ4_XS/Qwen3.8-Flash-Next-UD-IQ4_XS-00001-of-00003.gguf" \
  -md "$QWEN_DIR/MTP/mtp-Qwen3.8-Flash-Next-shared-Q8_0.gguf" \
  --spec-type draft-mtp --spec-draft-n-max 2 \
  -ngl 999 -fa on \
  -ctk q8_0 -ctv q8_0 \
  -c 262144 -b 4096 -ub 1024 \
  -t 4 --parallel 1 --jinja --no-webui \
  --host 127.0.0.1 --port 8080
Bei geteilten GGUF-Dateien reicht es, den ersten Teil (-00001-of-00003) anzugeben. llama.cpp lädt die übrigen Teile automatisch.
| Parameter | Bedeutung | Warum dieser Wert? |
|---|---|---|
-md |
lädt das MTP-Draft-Modell | Voraussetzung für spekulatives Decoding |
--spec-draft-n-max 2 |
bis zu 2 Token pro Schritt vorschlagen | Höhere Werte senken laut PR-Diskussion auf manchen Systemen die Akzeptanzrate; 2 war im Test stabil |
-ngl 999 |
alle Layer auf die GPU | Unified Memory: kein Grund, Layer auf der CPU zu lassen |
-fa on |
Flash Attention | Weniger Speicher für den KV-Cache, besonders bei langem Kontext |
-ctk / -ctv q8_0 |
KV-Cache in 8 Bit | Halbiert den KV-Cache-Bedarf gegenüber F16, Voraussetzung für 256K im Speicherbudget |
-c 262144 |
Kontextfenster 256K | Volles Kontextfenster des Modells |
-b 4096 -ub 1024 |
logische / physische Batch-Größe | Schnellere Verarbeitung langer Prompts |
-t 4 |
CPU-Threads | Bei vollem GPU-Offload bringen mehr Threads kaum Vorteile |
--parallel 1 |
ein gleichzeitiger Slot | Der volle Kontext steht einer Anfrage zur Verfügung |
--jinja |
Chat-Template aus der GGUF-Datei | Korrekte Formatierung inklusive Tool-Calls |
--no-webui |
keine eingebaute Weboberfläche | Reiner API-Betrieb |
--host 127.0.0.1 |
nur lokal erreichbar | Sicherer Standard, Freigabe im Netzwerk siehe Schritt 9 |
In einem zweiten Terminal testen:
curl http://localhost:8080/health| ✓ CheckpointDie Antwort lautet {„status“:“ok“}. Beende den Server anschließend mit Strg + C. |
-c 131072. Das spart mehrere Gigabyte KV-Cache.
-c 131072. Das spart mehrere Gigabyte KV-Cache.
Schritt 7: Als systemd-Dienst mit Autostart einrichten
Statt alle Pfade im Service-File zu wiederholen, lagern wir die Konfiguration in eine Umgebungsdatei aus. Änderungen am Kontext oder Port brauchen dann keinen Eingriff in die Unit.
mkdir -p ~/.config/llama-server ~/.config/systemd/user
nano ~/.config/llama-server/qwen.env
LLAMA_BIN=/home/DEIN-BENUTZER/llama.cpp/build-vulkan-mtp/bin/llama-server
MODEL=/mnt/models/Qwen3.8-Flash-Next-GGUF/UD-IQ4_XS/Qwen3.8-Flash-Next-UD-IQ4_XS-00001-of-00003.gguf
DRAFT=/mnt/models/Qwen3.8-Flash-Next-GGUF/MTP/mtp-Qwen3.8-Flash-Next-shared-Q8_0.gguf
CTX=262144
HOST=127.0.0.1
PORT=8080
EXTRA_ARGS=nano ~/.config/systemd/user/llama-server.service[Unit]
Description=Qwen3.8 Flash Next (llama-server)
After=network-online.target
StartLimitIntervalSec=0
[Service]
Type=simple
EnvironmentFile=%h/.config/llama-server/qwen.env
ExecStartPre=/usr/bin/test -f ${MODEL}
ExecStart=${LLAMA_BIN} -m ${MODEL} -md ${DRAFT} \
--spec-type draft-mtp --spec-draft-n-max 2 \
-ngl 999 -fa on -ctk q8_0 -ctv q8_0 \
-c ${CTX} -b 4096 -ub 1024 -t 4 --parallel 1 \
--jinja --no-webui --host ${HOST} --port ${PORT} $EXTRA_ARGS
Restart=always
RestartSec=5
MemoryMax=120G
TimeoutStopSec=30
[Install]
WantedBy=default.target| Zeile | Zweck |
|---|---|
EnvironmentFile |
liest Pfade und Werte aus qwen.env, %h steht für dein Home-Verzeichnis |
ExecStartPre |
startet nur, wenn das Modell erreichbar ist; sonst erneuter Versuch nach 5 s |
StartLimitIntervalSec=0 |
verhindert, dass systemd nach mehreren Fehlstarts aufgibt |
$EXTRA_ARGS |
ohne Klammern: systemd teilt den Inhalt in einzelne Argumente, leer = keine Argumente |
MemoryMax=120G |
harte Speichergrenze, damit das System bei Fehlkonfiguration bedienbar bleibt |
Dienst aktivieren. enable-linger sorgt dafür, dass der Benutzerdienst schon beim Booten startet, ohne dass du dich anmelden musst:
sudo loginctl enable-linger "$USER"
systemctl --user daemon-reload
systemctl --user enable --now llama-server
systemctl --user status llama-server --no-pagerSchritt 8: Die API nutzen
curl http://localhost:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model":"qwen","messages":[{"role":"user","content":"Hallo, wer bist du?"}],"max_tokens":200}'
Den Modellnamen wertet llama-server nicht aus, da nur ein Modell geladen ist. Ein beliebiger Wert wie „qwen“ genügt.
Python mit dem OpenAI-Client:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8080/v1",
    api_key="nicht-benoetigt"
)

antwort = client.chat.completions.create(
    model="qwen",
    messages=[
        {
            "role": "user",
            "content": "Fasse die Vorteile lokaler KI in drei Punkten zusammen."
        }
    ],
    temperature=1.0,
    top_p=0.95,
    extra_body={"top_k": 20},
)

print(antwort.choices[0].message.content)
Empfohlene Sampling-Werte laut Unsloth:
| Modus | temperature | top_p | top_k | presence_penalty |
|---|---|---|---|---|
| Thinking (Reasoning) | 1.0 | 0.95 | 20 | 0.0 |
| Standard (ohne Thinking) | 0.7 | 0.80 | – | 1.5 |
Schritt 9: Zugriff im Heimnetz absichern
Standardmäßig lauscht der Dienst nur auf 127.0.0.1. Für den Zugriff von anderen Geräten im Heimnetz gehören drei Dinge zusammen: Netzwerk-Bindung, API-Schlüssel und Firewall-Regel.
openssl rand -hex 24 # erzeugt einen zufälligen API-SchlüsselIn qwen.env anpassen:
HOST=0.0.0.0
EXTRA_ARGS=--api-key DEIN-SCHLUESSEL
Firewall nur für das eigene Netz öffnen (Beispiel für das Standardnetz einer FRITZ!Box):
sudo ufw allow from 192.168.178.0/24 to any port 8080 proto tcp
sudo ufw enable
systemctl --user restart llama-server
Clients nutzen dann http://IP-DES-SERVERS:8080/v1 und den Schlüssel als API-Key.
Schritt 10: Betrieb, Monitoring und Updates
| Aufgabe | Befehl |
|---|---|
| Logs ansehen | journalctl --user -u llama-server -n 100 --no-pager |
| Logs live verfolgen | journalctl --user -u llama-server -f |
| Neu starten | systemctl --user restart llama-server |
| Stoppen | systemctl --user stop llama-server |
| Nach Änderung an Unit oder .env | systemctl --user daemon-reload && systemctl --user restart llama-server |
| GPU-Auslastung beobachten | nvtop oder amdgpu_top (aus den Paketquellen bzw. vom Projekt) |
llama.cpp aktualisieren: Da der MTP-Patch noch nicht gemergt ist, empfiehlt sich ein separates Build-Verzeichnis. So läuft der funktionierende Dienst weiter, bis der neue Build getestet ist:
cd "$LLAMA_DIR" && git stash && git pull

# Patch erneut anwenden (oder entfällt, falls PR #28243 gemergt ist)

cmake -B build-vulkan-mtp-neu -S . -G Ninja \
  -DCMAKE_BUILD_TYPE=Release \
  -DGGML_VULKAN=ON \
  -DGGML_NATIVE=OFF \
  -DGGML_OPENMP=ON \
  -DGGML_LTO=ON \
  -DBUILD_SHARED_LIBS=OFF

cmake --build build-vulkan-mtp-neu --target llama-server -j"$(nproc)"

# Nach erfolgreichem Test LLAMA_BIN in qwen.env umstellen und Dienst neu starten
Fehlerbehebung
| Symptom | Ursache | Lösung |
|---|---|---|
| Allokationsfehler beim Laden, obwohl 128 GB verbaut sind | GTT-Limit des Kernels zu niedrig | Schritt 1 prüfen: dmesg | grep -i "gtt memory", Kernel-Parameter und BIOS-UMA-Einstellung |
| Dienst startet nach dem Booten nicht, „Model not found“ | Laufwerk nicht eingebunden | fstab-Eintrag aus Schritt 3 prüfen, mount | grep /mnt/models |
| Out of Memory während des Betriebs | Kontext zu groß | CTX=131072 in qwen.env setzen, daemon-reload und Neustart |
| „unknown argument: –spec-type“ | Patch fehlt oder falsches Binary | Patch erneut anwenden, LLAMA_BIN in qwen.env prüfen |
| Sehr langsame Generierung, GPU idle | Vulkan nutzt llvmpipe | vulkaninfo --summary prüfen, Mesa aktualisieren |
| Port 8080 belegt | anderer Dienst | ss -ltnp | grep :8080, ggf. PORT in qwen.env ändern |
| MTP bringt keinen Geschwindigkeitsgewinn | niedrige Akzeptanzrate | Logs auf die Draft-Akzeptanz prüfen; --spec-draft-n-max 2 beibehalten |
FAQ
Warum Vulkan und nicht ROCm?
Das Vulkan-Backend von llama.cpp läuft auf Strix Halo mit dem Mesa-Treiber ohne zusätzliche Treiberinstallation und war in unserem Test stabil. ROCm ist eine Alternative, erfordert aber eine passende ROCm-Version und mehr Einrichtungsaufwand.
Warum UD-IQ4_XS und nicht eine höhere Quantisierung?
Mit 93,7 GB lässt UD-IQ4_XS gerade genug Platz für MTP-Draft und 256K Kontext im 128-GB-Budget. Laut Unsloth erreicht diese Variante eine Top-1-Übereinstimmung von rund 89,5 % mit dem unquantisierten Modell. Größere Quantisierungen würden den Kontext stark einschränken.
Warum nur zwei Draft-Token?
In der Diskussion zu PR #28243 zeigen höhere Werte je nach Hardware stark schwankende Akzeptanzraten, teilweise mit Geschwindigkeitsverlust. Mit zwei Draft-Token lief das Setup im Test stabil. Du kannst höhere Werte ausprobieren und die Token/s in den Logs vergleichen.
Kann ich parallel ein zweites Modell betreiben?
Nicht mit dieser Konfiguration. Qwen3.8 Flash Next belegt bei 256K Kontext rund 110 GB. Für mehrere Modelle solltest du den Kontext deutlich reduzieren oder kleinere Modelle wählen.
Bleiben meine Daten lokal?
Ja. Nach dem Download läuft alles offline auf deinem Rechner. Solange du Port 8080 nicht ins Internet freigibst, verlassen keine Anfragen dein Netzwerk.
Fazit
Mit selbst kompiliertem llama.cpp, Vulkan und MTP holst du aus dem GEEKOM A9 Mega mit Strix Halo und 128 GB ein Setup heraus, das ein 125B-Modell mit vollem 256K-Kontext als dauerhaften Dienst bereitstellt. Die entscheidenden Stellschrauben sind das GTT-Limit im Kernel, ein fest eingebundenes Modell-Laufwerk und ein systemd-Dienst mit ausgelagerter Konfiguration. Da der MTP-Patch noch in Entwicklung ist, lohnt es sich, PR #28243 im Blick zu behalten.