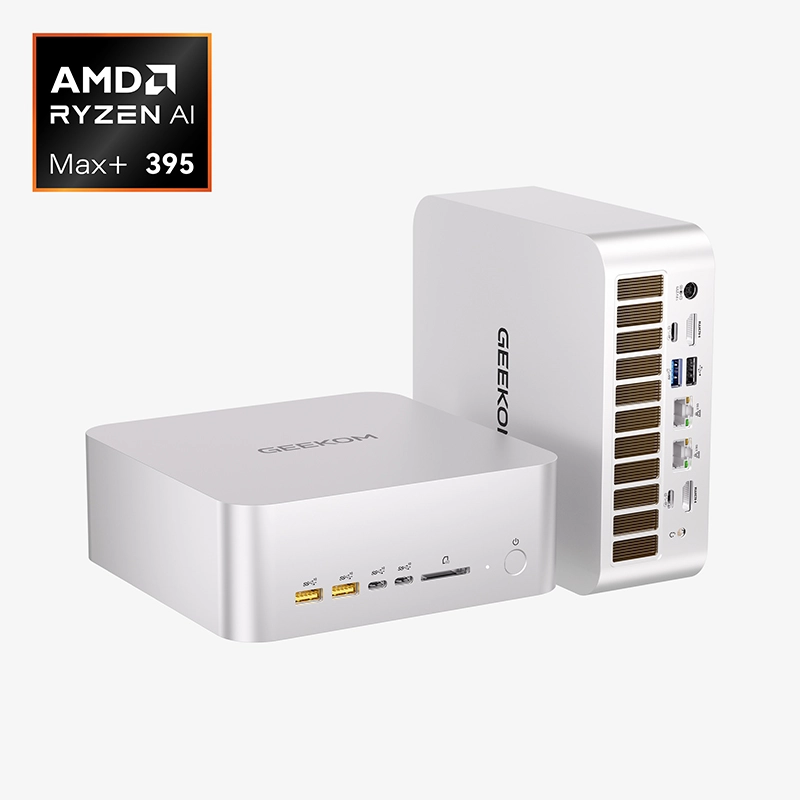

Kann ein Mini PC ein Sprachmodell mit über 100 GB allein ausführen, ohne zweites Gerät und ohne Cluster? Wir haben es ausprobiert: Ein einzelner GEEKOM A9 Mega mit AMD Ryzen AI Max+ 395 und 128 GB Arbeitsspeicher hat Qwen3.8 Flash Next in der Quantisierung UD-Q4_K_XL (111,4 GB) ausgeführt, von kurzen Eingaben bis zu 128.000 Token Kontext.
Das Ergebnis in Kürze:
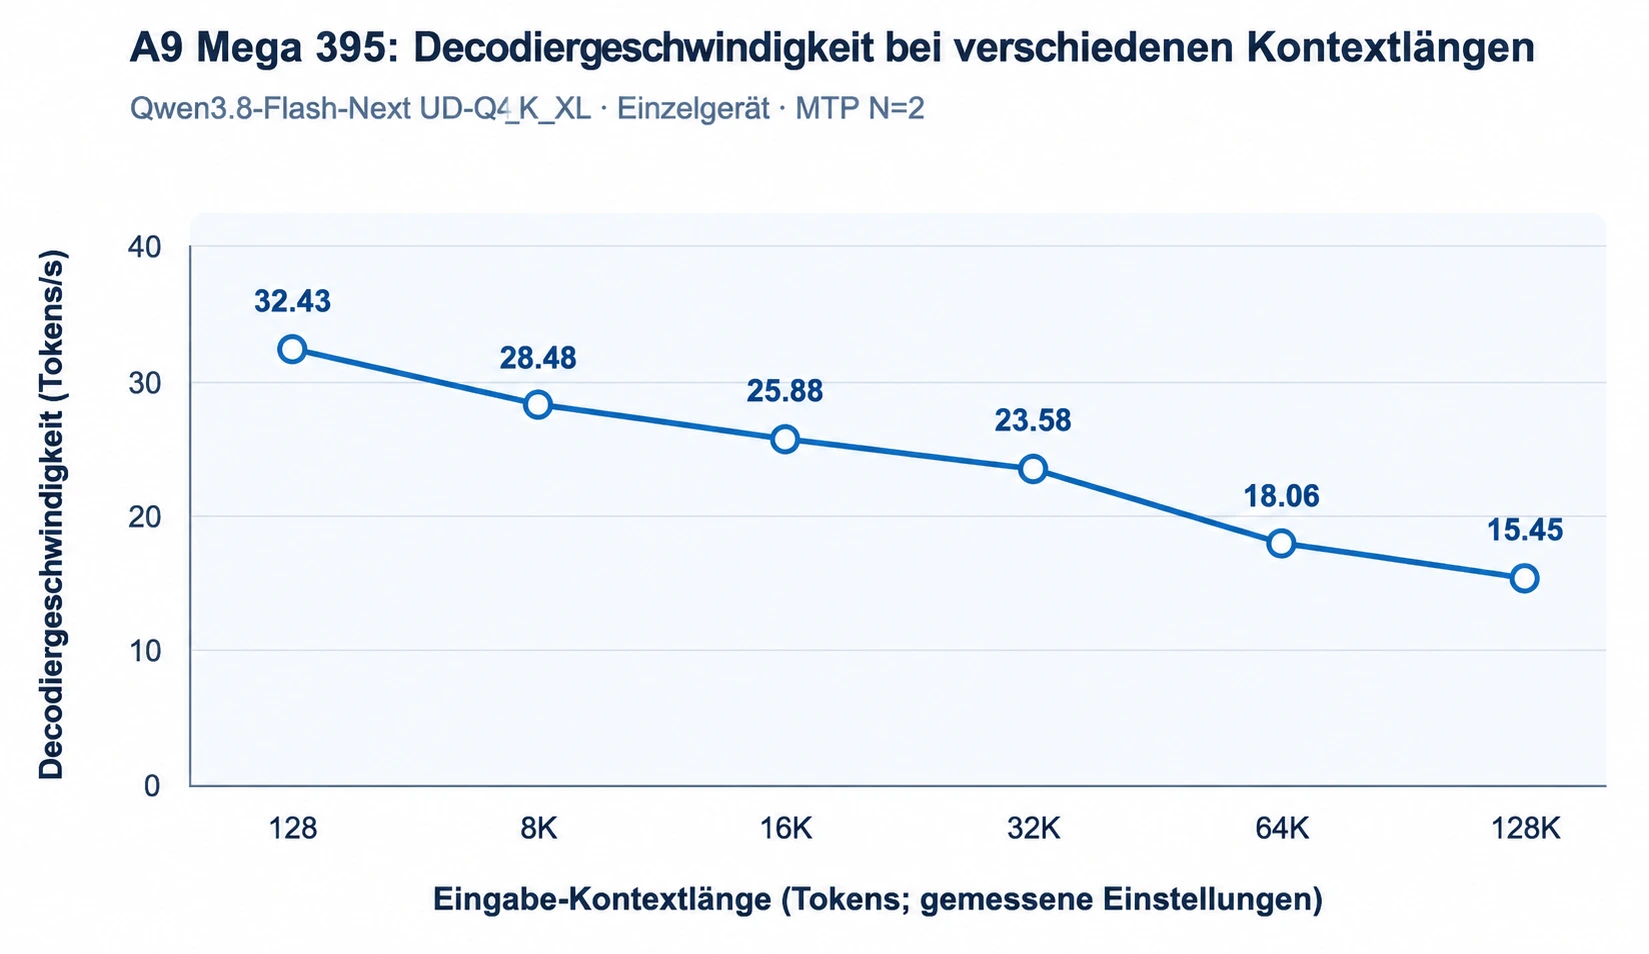
- 32,43 Token/s bei einer kurzen Eingabe mit 128 Token
- 15,45 Token/s bei einer Eingabe mit 128.000 Token (128K)
- rund 12 Minuten Wartezeit bis zum ersten Token bei 128K
Alle Werte stammen aus dokumentierten Testläufen mit Startbefehl, Modelldateien und Software-Version. Die Rohdaten haben wir öffentlich auf GitHub und Hugging Face bereitgestellt, sodass Sie den Test nachprüfen können.
Qwen3.8 Flash Next Benchmark: alle Messwerte von 128 bis 128K Token
Wir haben sechs Eingabelängen getestet. Die Ausgabegeschwindigkeit halbiert sich dabei ungefähr, von 32,43 auf 15,45 Token/s. Die Wartezeit bis zum ersten Token steigt dagegen um ein Vielfaches.
| Eingabe (Token) |
Ausgabe (Token) |
Zeit bis zum 1. Token (s) |
Prefill (Token/s) |
Ausgabe (Token/s) |
Gesamtzeit (s) |
GPU-Speicher in GB (ausgelagert) |
|---|---|---|---|---|---|---|
| 128 | 5.000 | 0,97 | 132,22 | 32,43 | 155,15 | 101,61 (+30,17) |
| 8K | 1.604 | 26,96 | 303,83 | 28,48 | 83,28 | 101,71 (+30,87) |
| 16K | 2.617 | 58,33 | 280,89 | 25,88 | 159,45 | 101,84 (+31,89) |
| 32K | 2.695 | 112,14 | 292,21 | 23,58 | 226,43 | 101,80 (+30,96) |
| 64K | 1.965 | 283,41 | 231,24 | 18,06 | 392,22 | 102,14 (+31,54) |
| 128K | 5.000 | 720,61 | 181,89 | 15,45 | 1.044,24 | 102,50 (+32,56) |
*Gemessen mit llama.cpp Build b10909-mix-bea84f7 (Unsloth), Einstellungen: -c 256000, -fa on, -b 4096 -ub 2048, -np 1, -ngl 99, MTP-Draft-Modell mit –spec-draft-n-max 2, ein Gerät (ohne –rpc). Die Werte in Klammern geben den in den Systemspeicher ausgelagerten Teil an.
Da die Ausgabelänge je Durchlauf unterschiedlich war, sollten Sie vor allem die Ausgabegeschwindigkeit und die Zeit bis zum ersten Token vergleichen, nicht die Gesamtzeit.
So lesen Sie die Werte
- Zeit bis zum ersten Token (TTFT): wie lange Sie warten, bis die Antwort beginnt. Sie wächst mit der Länge der Eingabe.
- Prefill: wie schnell das Modell Ihre Eingabe einliest, in Token pro Sekunde.
- Ausgabe (Decode): wie schnell die Antwort geschrieben wird. Das ist die Geschwindigkeit, die Sie beim Mitlesen sehen.
- Gesamtzeit: Wartezeit plus Zeit für die komplette Antwort in diesem Durchlauf.
Langer Kontext: Es funktioniert, aber Sie müssen warten
Lange Eingaben laufen stabil, verursachen aber spürbare Wartezeiten. Sobald die Antwort beginnt, ist sie selbst bei 128K noch schneller, als die meisten Menschen lesen.
| Eingabelänge | Wartezeit bis zum ersten Token | Ausgabegeschwindigkeit |
|---|---|---|
| 128 Token | Unter 1 Sekunde | 32,43 Token/s |
| 8K | Ca. 27 Sekunden | 28,48 Token/s |
| 32K | Ca. 1 Minute 52 Sekunden | 23,58 Token/s |
| 64K | Ca. 4 Minuten 43 Sekunden | 18,06 Token/s |
| 128K | Ca. 12 Minuten | 15,45 Token/s |
Was bedeutet das in der Praxis?
- Chat, Programmierhilfe und kurze Dokumente mit bis zu einigen Tausend Token reagieren flüssig.
- Rund 32K Token, etwa ein langer Bericht oder ein größerer Ausschnitt aus einer Codebasis, bedeuten etwa zwei Minuten Wartezeit, bevor die Antwort startet.
- Ab etwa 64K bis 128K behandeln Sie Aufgaben am besten als Stapelverarbeitung: Auftrag starten, später Ergebnis abholen.
Für lange Dokumente ist also die Wartezeit bis zum ersten Token der entscheidende Wert, nicht die Ausgabegeschwindigkeit.
Wie passt ein 111-GB-Modell in 128 GB?
Speicheraufteilung
Im Test belegte das Modell 101,61 bis 102,50 GB Grafikspeicher. Weitere 30,17 bis 32,56 GB lagen im Systemspeicher, dort befinden sich die N-Gramm-Embedding-Daten des Modells. Zusammen sind das 131,78 bis 135,06 GB und damit mehr als die verbauten 128 GB. Der überschüssige Teil kann über den Auslagerungsspeicher (Swap) des Systems laufen.
Modellgewichte, das 2,8 GB große Draft-Modell, die Laufzeitumgebung und der KV-Cache teilen sich diesen Speicher. Die Speichergröße begrenzt deshalb sowohl die Modellgröße als auch die mögliche Kontextlänge. Warum der gemeinsame Speicher des Ryzen AI Max+ 395 dafür so wichtig ist, erklären wir in Unified Memory vs. VRAM: Was zählt für lokale LLMs?
Warum die GGUF-Quantisierung UD-Q4_K_XL?
Die folgenden Werte stammen aus der Quantisierungsanalyse von Unsloth für dieses Modell. „Top-1-Übereinstimmung“ gibt an, wie oft das quantisierte Modell dasselbe nächste Token wählt wie das Referenzmodell. Je niedriger die mittlere KL-Divergenz (KLD), desto näher liegen die Ausgaben am Original. Beide Werte messen keine Genauigkeit bei konkreten Aufgaben.
| GGUF-Quantisierung | Größe (GB) | Top-1-Übereinstimmung (%) | Mittlere KLD |
|---|---|---|---|
| UD-Q2_K_XL | 78,9 | 82,715 | 0,224607 |
| UD-IQ4_XS | 93,7 | 89,554 | 0,083630 |
| UD-Q4_K_XL (getestet) | 111,3 | 92,255 | 0,046893 |
| UD-Q5_K_XL | 158,3 | 93,680 | 0,030415 |
| Q8_0 | 188,2 | 94,122 | 0,026574 |
UD-Q4_K_XL erreicht rund 92 % Top-1-Übereinstimmung. Q5 und Q8 bringen nur 1 bis 2 Prozentpunkte mehr, sind aber 1,4- bis 1,7-mal so groß und passen nicht mehr in ein Gerät mit 128 GB. Die 2-Bit-Variante spart etwa 32 GB, fällt aber unter 83 % Übereinstimmung.
Was bringt MTP?
Bei der Multi-Token-Vorhersage (MTP) schlägt ein kleines Draft-Modell mit 2,8 GB bis zu zwei Token im Voraus vor, das Hauptmodell prüft sie. Das ist das übliche spekulative Decoding von llama.cpp. Einen Vergleichslauf ohne MTP haben wir nicht aufgezeichnet. Eine konkrete Beschleunigung nennen wir deshalb nicht.
Hinweis: In unserer Schritt-für-Schritt-Anleitung für Qwen3.8 Flash Next unter Ubuntu nutzen wir eine andere Konfiguration (UD-IQ4_XS mit Vulkan). Die Werte dort sind deshalb nicht direkt mit diesem Test vergleichbar.
Für wen eignet sich dieses Setup und für wen nicht?
Gut geeignet, wenn Sie:
- ein lokales LLM nutzen möchten und Ihre Daten auf dem eigenen Gerät bleiben sollen,
- lange Dokumente mit 64K bis 128K Token als Stapelauftrag verarbeiten,
- die Plattform Ryzen AI Max+ 395 mit nachvollziehbaren Messwerten bewerten wollen,
- nach der Einrichtung offline arbeiten möchten.
Weniger geeignet, wenn Sie:
- 256K Kontext auf einem Gerät brauchen: Der Startbefehl erlaubt das, ein Messwert mit 256K auf einem Gerät liegt aber nicht vor,
- sehr lange Eingaben in Echtzeit beantwortet haben möchten: Ab 32K warten Sie mehrere Minuten.
Und der A9 Mega mit 64 GB? Der A9 Mega mit Ryzen AI Max+ 388 und 64 GB kann dieses Modell nicht allein ausführen. In unseren Tests lief es dort als Verbund aus zwei A9 Mega und erreichte bei 128 Token Eingabe 30,76 Token/s. Welche Mini PCs sich generell für lokale Modelle eignen, zeigt unser Ratgeber Die besten Mini PCs, um LLMs lokal zu betreiben.
Test nachmachen: Aufbau und Startbefehl
| Komponente | Konfiguration |
|---|---|
| Gerät | GEEKOM A9 Mega 395 |
| Prozessor | AMD Ryzen AI Max+ 395 (16 Kerne / 32 Threads) |
| Grafik | AMD Radeon 8060S |
| Arbeitsspeicher | 128 GB, 256 GB/s Bandbreite |
| Betriebssystem | Ubuntu 26.04 |
| Grafiktreiber / ROCm | 31.50.0.0 / ROCm 10.0.0 |
| Inferenz-Engine | llama.cpp Build b10909-mix-bea84f7 (Unsloth) |
| Hauptmodell | Qwen3.8-Flash-Next-UD-Q4_K_XL.gguf, 111,4 GB in vier Teilen |
| Draft-Modell | mtp-Qwen3.8-Flash-Next-Q4_K_M.gguf, 2,8 GB, MTP N=2 |
| Wichtige Einstellungen |
-c 256000,
-fa on,
-b 4096,
-ub 2048,
-np 1,
ein Gerät (ohne --rpc)
|
Mehr zu Leistung und Grafik der Plattform finden Sie in unserem AMD Ryzen AI Max+ 395 Test und im Überblick AMD Strix Halo Mini PC.
Startbefehl
$ ./llama-server \
  -m /home/user/mode/Qwen3.8-Flash-Next-UD-Q4_K_XL/Qwen3.8-Flash-Next-UD-Q4_K_XL-00001-of-00004.gguf \
  -ngl 99 \
  -c 256000 \
  -b 4096 \
  -ub 2048 \
  -fa on \
  -np 1 \
  --host 127.0.0.1 \
  --port 8080 \
  --metrics \
  -lv 4 \
  -md /home/user/mode/Qwen3.8-Flash-Next-UD-Q4_K_XL/mtp-Qwen3.8-Flash-Next-Q4_K_M.gguf \
  -ngld 99 \
  --spec-type draft-mtp \
  --spec-draft-n-max 2
Die Dateipfade stammen von unserem Testsystem. Passen Sie sie an Ihr System an.
Einrichtung und Download
Führen Sie die Skripte im Hauptverzeichnis unseres GitHub-Repositorys aus, auf einem nativ installierten Ubuntu 26.04 (x86-64):
bash scripts/setup-ubuntu-26.04.shinstalliert die Voraussetzungen, die Hugging Face CLI und ROCm 10.0.0.python3 scripts/download-models.py flagshiplädt die vier Modellteile und das MTP-Draft-Modell.python3 scripts/download-llama-cpp.py 395lädt den passenden llama.cpp-Build.
Prüfen Sie vor einem Vergleich Ihre Treiber- und ROCm-Version. Fragen und eigene Ergebnisse können Sie über GitHub Issues melden.
Grenzen dieses Tests
- Getestet wurde bis 128K Kontext. Ein Ergebnis mit 256K auf einem Gerät gibt es nicht.
- BIOS-Version, NPU-Treiber und Energieprofil sind noch nicht bestätigt.
- Die Ergebnisse hängen von llama.cpp-Build, Betriebssystem, Modelldatei, Kontextlänge, Energieprofil und Hintergrundlast ab.
- „Lokal“ heißt nicht ab dem ersten Tag offline: Für Download und Einrichtung brauchen Sie Internet.
- Antworten eines Sprachmodells können falsch sein. Verlassen Sie sich bei medizinischen, rechtlichen, finanziellen oder sicherheitsrelevanten Entscheidungen nicht allein darauf.
Fazit
Ein einzelner GEEKOM A9 Mega 395 führt Qwen3.8 Flash Next mit 111,4 GB vollständig lokal aus. Bei kurzen Eingaben antwortet das Modell mit rund 32 Token/s und fühlt sich im Chat flüssig an. Lange Kontexte bis 128K funktionieren ebenfalls, kosten aber Minuten bis zur ersten Antwort. Für Analysen großer Dokumente sollten Sie das einplanen. Wer ein großes lokales LLM ohne Cluster und ohne Cloud betreiben möchte, bekommt mit dem A9 Mega mit 128 GB eine kompakte Lösung.
FAQ
Kann der A9 Mega 395 Qwen3.8 Flash Next allein ausführen?
Ja. Die Version UD-Q4_K_XL mit 111,4 GB lief auf einem einzigen Gerät, mit Eingaben von 128 Token bis 128K.
Wie schnell ist Qwen3.8 Flash Next auf dem A9 Mega?
Bei 128 Token Eingabe erreichte das Modell 32,43 Token/s, bei 32K 23,58 Token/s und bei 128K 15,45 Token/s (llama.cpp b10909-mix-bea84f7, Ubuntu 26.04, ROCm 10.0.0, MTP N=2).
Wie viel Speicher braucht Qwen3.8 Flash Next?
Im Test belegte das Modell 101,61 bis 102,50 GB Grafikspeicher und zusätzlich 30,17 bis 32,56 GB im Systemspeicher. Die Summe kann wegen des Auslagerungsspeichers über 128 GB liegen.
Unterstützt das Setup 256K Kontext?
Der Startbefehl ist auf 256.000 Token eingestellt. Gemessen haben wir aber nur bis 128K. Leistungswerte für 256K nennen wir deshalb nicht.
Kann ich den Test selbst nachmachen?
Ja. Mit unserem öffentlichen Repository, dem Startbefehl, dem llama.cpp-Build und den Einrichtungsskripten. Passen Sie die Dateipfade an und prüfen Sie Treiber- und ROCm-Version.