Einleitung
Wer ein lokales LLM betreiben möchte, stellt schnell fest: Die wichtigste Hardware-Frage ist nicht der Prozessor, sondern der Speicher. Ein Sprachmodell muss vollständig in den Speicher passen, bevor es überhaupt antworten kann. Wie schnell es antwortet, hängt dann vor allem davon ab, wie schnell dieser Speicher Daten liefert.
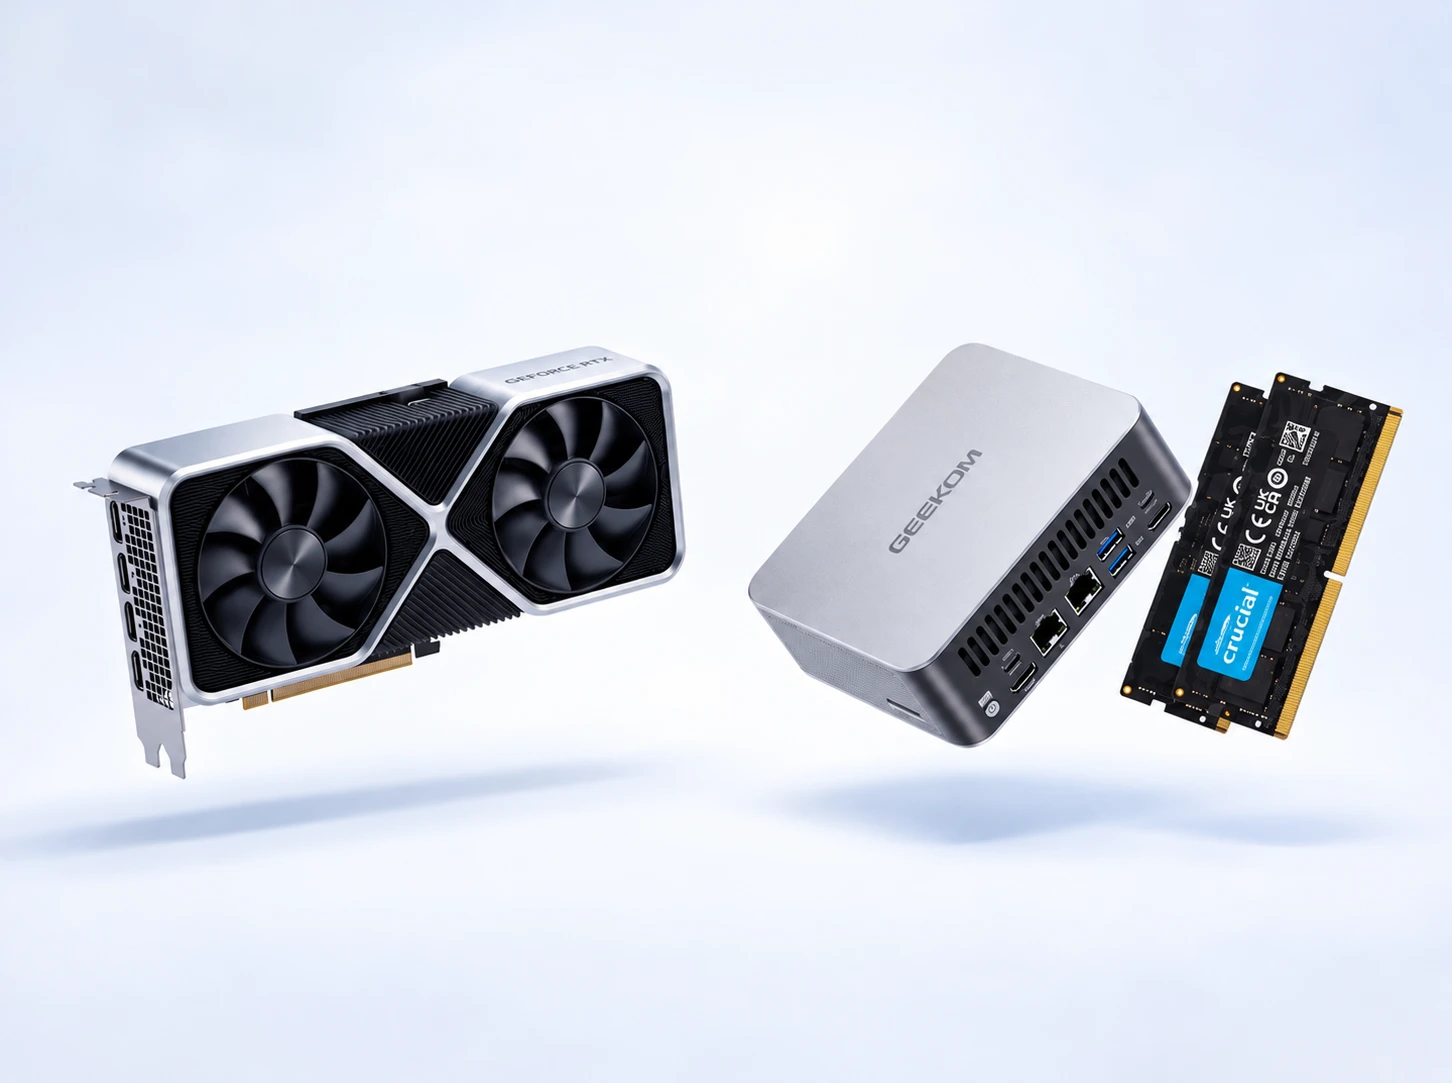
Genau hier unterscheiden sich die beiden Ansätze. Eine Grafikkarte mit dediziertem VRAM ist sehr schnell, bietet aber meist nur 8 bis 24 GB. Ein Rechner mit Unified Memory teilt sich einen großen Speicher zwischen CPU und Grafik – mit 64 oder 128 GB passen auch große Modelle hinein, dafür ist er langsamer. Welche Lösung besser ist, hängt also davon ab, was Sie gerade ausbremst: zu wenig Platz oder zu wenig Tempo.
In diesem Ratgeber erklären wir die Unterschiede verständlich, rechnen den Speicherbedarf an Beispielen vor und zeigen mit eigenen Messwerten, was ein Mini-PC mit Unified Memory in der Praxis leistet.
Das Wichtigste in Kürze
- Passt das Modell nicht in den Speicher, läuft es gar nicht – oder nur extrem langsam. Kapazität kommt deshalb immer zuerst.
- Dedizierter VRAM ist schneller, weil Grafikkarten eine Speicherbandbreite von mehreren hundert bis über 1.000 GB/s erreichen.
- Unified Memory bietet mehr Platz: Mit 64 oder 128 GB lassen sich Modelle ausführen, die auf keine Gaming-Grafikkarte mit 24 GB passen.
- Faustregel für den Speicherbedarf: Ein Modell mit 4-Bit-Quantisierung braucht etwa 0,5 Byte pro Parameter plus Puffer – ein 70B-Modell also rund 40 GB.
- Für eine Person zu Hause ist Unified Memory oft die preiswertere Lösung. Für viele gleichzeitige Nutzer oder zeitkritische Anwendungen bleibt dedizierter VRAM die bessere Wahl.
VRAM und Unified Memory: zwei unterschiedliche Konzepte
Dedizierter VRAM sitzt direkt auf der Grafikkarte. Er gehört allein der GPU und ist als GDDR6, GDDR7 oder HBM auf maximale Geschwindigkeit ausgelegt. Betriebssystem und Programme greifen nicht darauf zu, deshalb steht er vollständig für das KI-Modell bereit.
Unified Memory (auch gemeinsamer oder einheitlicher Speicher) ist ein einziger Speicherpool, den sich CPU und integrierte Grafik teilen. Diese Architektur findet sich bei Apple-Chips, bei AMD-Prozessoren mit integrierter Radeon-Grafik wie der Ryzen-AI-Serie und bei Intel-Prozessoren mit integrierter Grafik. In Windows-PCs kommt meist DDR5- oder LPDDR5X-Speicher zum Einsatz. Er bietet viel Platz, ist aber deutlich langsamer als der Speicher einer Grafikkarte.
| Merkmal | Dedizierter VRAM | Unified Memory |
|---|---|---|
| Ort | Auf der Grafikkarte | Ein gemeinsamer Pool für CPU und GPU |
| Typische Größe | 8–24 GB (Consumer-Grafikkarten) | 32–128 GB |
| Speicherbandbreite | Mehrere hundert bis über 1.000 GB/s | Rund 90 bis 256 GB/s |
| Stärke | Schnelle Textausgabe | Platz für große Modelle |
| Schwäche | Viel Speicher ist sehr teuer | Langsamere Textausgabe |
Dedizierter und gemeinsamer GPU-Speicher im Task-Manager
Unter Windows zeigt der Task-Manager beide Speicherarten an: Unter Leistung → GPU finden Sie „Dedizierter GPU-Speicher“ und „Gemeinsamer GPU-Speicher“. Bei einer Grafikkarte entspricht der dedizierte Wert dem VRAM. Bei integrierter Grafik ist der dedizierte Wert der Anteil des Arbeitsspeichers, der fest für die GPU reserviert ist. Der gemeinsame GPU-Speicher ist normaler Arbeitsspeicher, den die Grafik bei Bedarf zusätzlich nutzen darf.
VRAM erhöhen bei integrierter Grafik
Bei einer Grafikkarte lässt sich VRAM nicht erweitern. Bei integrierter Grafik können Sie dagegen festlegen, wie viel Arbeitsspeicher die GPU fest reserviert bekommt:
- Im BIOS/UEFI über eine Option wie „UMA Frame Buffer Size“ oder „iGPU Memory“.
- Bei AMD-Systemen unter Windows zusätzlich über „Variable Graphics Memory“ in der AMD-Software: Adrenalin Edition.
Für lokale LLMs lohnt sich ein großer GPU-Anteil, weil das Modell dann vollständig von der Grafik verarbeitet wird. Lassen Sie aber genug Speicher für Windows und Ihre Programme übrig – als Richtwert mindestens 16 GB.
Wie viel Speicher braucht ein lokales LLM?
Der größte Teil des Speichers geht für die Gewichte des Modells drauf. Wie viel das ist, hängt von der Anzahl der Parameter und der Quantisierung ab:
- FP16 (volle Genauigkeit): etwa 2 Byte pro Parameter
- Q4/INT4 (4-Bit-Quantisierung): etwa 0,5 Byte pro Parameter
Dazu kommen Puffer für die Laufzeitumgebung und der sogenannte KV-Cache, der mit der Länge des Gesprächs wächst. Bei Unified Memory braucht außerdem das Betriebssystem einen Teil desselben Speichers.
| Modellgröße | FP16 | Q4 (inkl. Puffer) | Passt auf |
|---|---|---|---|
| 7–8B | ca. 16 GB | ca. 5 GB | Fast jede Grafikkarte ab 8 GB |
| 14B | ca. 28 GB | ca. 9 GB | Grafikkarte ab 12 GB |
| 32B | ca. 64 GB | ca. 20 GB | Grafikkarte mit 24 GB oder Unified Memory ab 32 GB |
| 70B | ca. 140 GB | ca. 40 GB | Nur Unified Memory ab 64 GB (oder mehrere Grafikkarten) |
| 120B | ca. 240 GB | ca. 65 GB | Unified Memory mit 128 GB |
Richtwerte. Der tatsächliche Bedarf hängt vom Modell, der Quantisierungsvariante und der Kontextlänge ab.
Der KV-Cache wird oft unterschätzt. Bei langen Chats oder großen Dokumenten kann er mehrere Gigabyte belegen. Planen Sie deshalb immer etwas mehr Speicher ein, als die Modelldatei groß ist.
Warum mehr Speicher oft wichtiger ist als VRAM
Ein Modell, das nicht in den Speicher passt, läuft entweder gar nicht oder wird teilweise auf den deutlich langsameren Arbeitsspeicher und die CPU ausgelagert. Dann sinkt die Geschwindigkeit drastisch.
Gaming-Grafikkarten haben typischerweise 8, 12, 16 oder 24 GB VRAM. Für 64 oder 128 GB dedizierten Grafikspeicher brauchen Sie mehrere Grafikkarten, eine Workstation-GPU oder Rechenzentrums-Hardware – das kostet schnell mehrere tausend Euro.
Ein Mini-PC mit Unified Memory löst dieses Problem anders: Mit 64 oder 128 GB gemeinsamem Speicher passen auch 70B- und 120B-Modelle hinein. Ein 70B-Modell in Q4 braucht etwa 40 GB – auf einer Grafikkarte mit 24 GB läuft es nicht vollständig, mit 64 GB Unified Memory schon.
Warum dedizierter VRAM trotzdem schneller ist
Beim Erzeugen jedes einzelnen Tokens muss der Rechner die Gewichte des Modells aus dem Speicher lesen. Als grobe Faustregel gilt deshalb:
\text{Tokens pro Sekunde} \approx \frac{\text{Speicherbandbreite}}{\text{gelesene Datenmenge pro Token}}Das ist eine theoretische Obergrenze. Die echte Geschwindigkeit hängt zusätzlich von Software, Kontextlänge und Chip-Architektur ab.
| System | Speicherbandbreite | 70B-Modell in Q4 (ca. 40 GB), theoretisches Maximum |
|---|---|---|
| Typischer Mini-PC (DDR5, 128 Bit) | ca. 90 GB/s | ca. 2 Tokens/s |
| AMD Ryzen AI Max+ (LPDDR5X, 256 Bit) | bis zu 256 GB/s | ca. 6 Tokens/s |
| High-End-Grafikkarte (GDDR7) | über 1.000 GB/s | ca. 25 Tokens/s Passt aber nicht in 24 GB VRAM |
Ausnahme: MoE-Modelle. Bei Mixture-of-Experts-Modellen wird pro Token nur ein kleiner Teil der Parameter gelesen. Qwen3.6-35B-A3B hat zum Beispiel 35 Milliarden Parameter, nutzt pro Token aber nur rund 3 Milliarden. Deshalb ist es auf Unified Memory viel schneller, als die Modellgröße vermuten lässt – in unserem Test 68 Tokens pro Sekunde (siehe unten).
Passt nicht oder zu langsam? So finden Sie Ihren Engpass
- Das Modell passt nicht in den Speicher: Dann hilft nur mehr Speicher. Eine schnellere Grafikkarte mit zu wenig VRAM bringt nichts.
- Das Modell passt, antwortet aber zu langsam: Dann brauchen Sie mehr Speicherbandbreite – oder ein kleineres bzw. ein MoE-Modell.
| Unified Memory passt zu Ihnen, wenn … | Dedizierter VRAM passt zu Ihnen, wenn … |
|---|---|
| Sie das Modell allein nutzen | Mehrere Personen gleichzeitig darauf zugreifen |
| Datenschutz und lokale Verarbeitung wichtig sind | Antworten in Echtzeit nötig sind |
| Sie große Modelle ausprobieren möchten | Sie oft sehr lange Texte erzeugen |
| Ein leiser, sparsamer Rechner gewünscht ist | Leistung wichtiger ist als Stromverbrauch und Lautstärke |
Für den Alltag gilt: Ein kleineres Modell auf einer schnellen Grafikkarte fühlt sich oft flüssiger an als ein großes Modell, das gerade so in den gemeinsamen Speicher passt.
Praxistest: So schnell laufen lokale LLMs auf Unified Memory
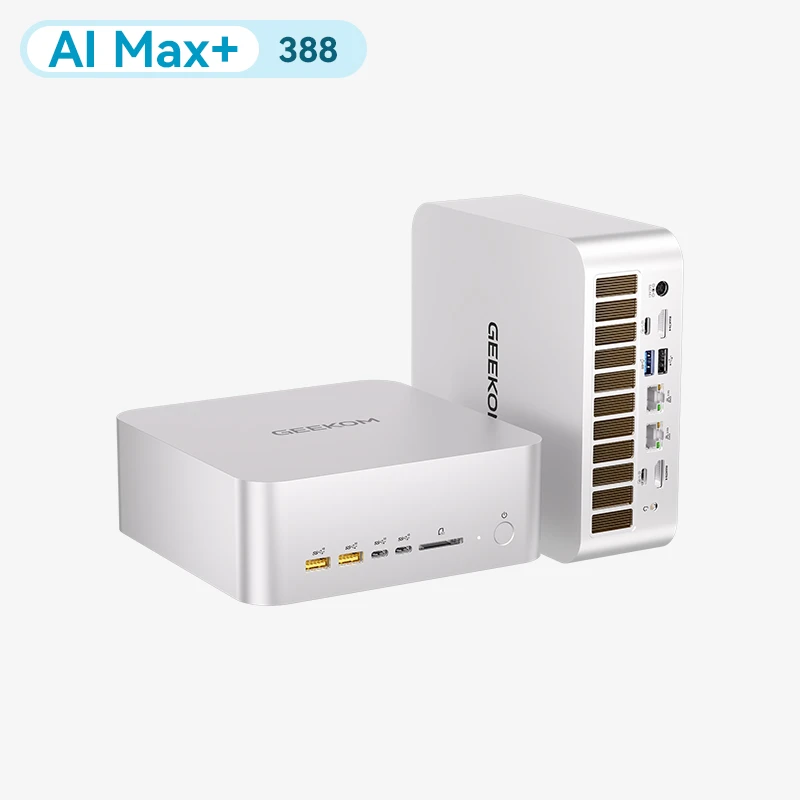
Um die Theorie zu überprüfen, haben wir mehrere Modelle auf dem GEEKOM A9 Mega getestet. Der Mini-PC nutzt Unified Memory mit 256-Bit-Speicherbus und ist mit AMD Ryzen AI Max+ 395 oder Ryzen AI Max+ 388 erhältlich.
Testaufbau: llama.cpp (llama-server) mit GPU-Beschleunigung, quantisierte GGUF-Modelle, kurze Eingabe mit 128 Tokens, jeweils ein Rechner.
| Prozessor | Modell | Dateigröße | Ausgabe | Erstes Token | Belegter Speicher |
|---|---|---|---|---|---|
| Ryzen AI Max+ 388 | Qwen3.6-35B-A3B (Q4, MoE, MTP) | 22,7 GB | 68,0 Tokens/s | 0,5 s | 33,3 GB |
| Ryzen AI Max+ 395 | Qwen3.8-27B (FP4, MTP) | 14,6 GB | 31,3 Tokens/s | 1,5 s | 26,8 GB |
| Ryzen AI Max+ 388 | Gemma-4-31B (Q4) | 16,4 GB | 11,3 Tokens/s | 8,7 s | 40,8 GB |
| Ryzen AI Max+ 395 | DeepSeek-V4-Flash (Q2) | 96,8 GB | 14,7 Tokens/s | 3,5 s | 113,0 GB |
| Ryzen AI Max+ 395 | Qwen3.8-Flash-Next (Q4, MTP) | 111,4 GB | 32,4 Tokens/s | 3,8 s | 101,6 GB |
Was bedeutet MTP? MTP steht für Multi-Token-Prediction: Ein kleines Hilfsmodell schlägt mehrere Tokens auf einmal vor, die das Hauptmodell anschließend überprüft. Das kann die Textausgabe beschleunigen.
Was die Ergebnisse zeigen:
- Große Modelle laufen tatsächlich: Modelle mit fast 100 GB und mehr laufen auf einem einzigen Mini-PC – auf keiner Gaming-Grafikkarte wäre das möglich.
- Die Geschwindigkeit ist alltagstauglich: Ab etwa 10 Tokens pro Sekunde erscheint der Text schneller, als man liest.
- MoE und MTP machen den Unterschied: Qwen3.6-35B-A3B erreicht 68 Tokens pro Sekunde, während das klassisch aufgebaute Gemma-4-31B bei ähnlicher Dateigröße auf 11,3 Tokens pro Sekunde kommt.
- Lange Texte bremsen: Bei 128.000 Tokens Eingabe sinkt Qwen3.6-35B-A3B auf 32,6 Tokens pro Sekunde, und bis zum ersten Token vergehen gut drei Minuten.
Hinweis: Die Tests auf beiden Prozessoren nutzen unterschiedliche Quantisierungen und Softwareversionen. Die Werte zeigen, was möglich ist, und eignen sich nicht für einen direkten Vergleich zwischen 395 und 388.
Was das für Mini PCs bedeutet
Moderne Mini-PCs mit AMD Ryzen nutzen Unified Memory, laufen mit Windows oder Linux und brauchen viel weniger Platz und Strom als eine Workstation mit Grafikkarte. Sie eignen sich gut als privater KI-Assistent, für die Suche in eigenen Dokumenten oder als leiser Rechner, der im Hintergrund durchläuft. Einen Server, der viele Anfragen gleichzeitig beantwortet, ersetzen sie nicht.
Welcher GEEKOM Mini PC passt, hängt von der Modellgröße ab:
| Modelle | Empfehlung | Speicher |
|---|---|---|
| 7B bis 32B |
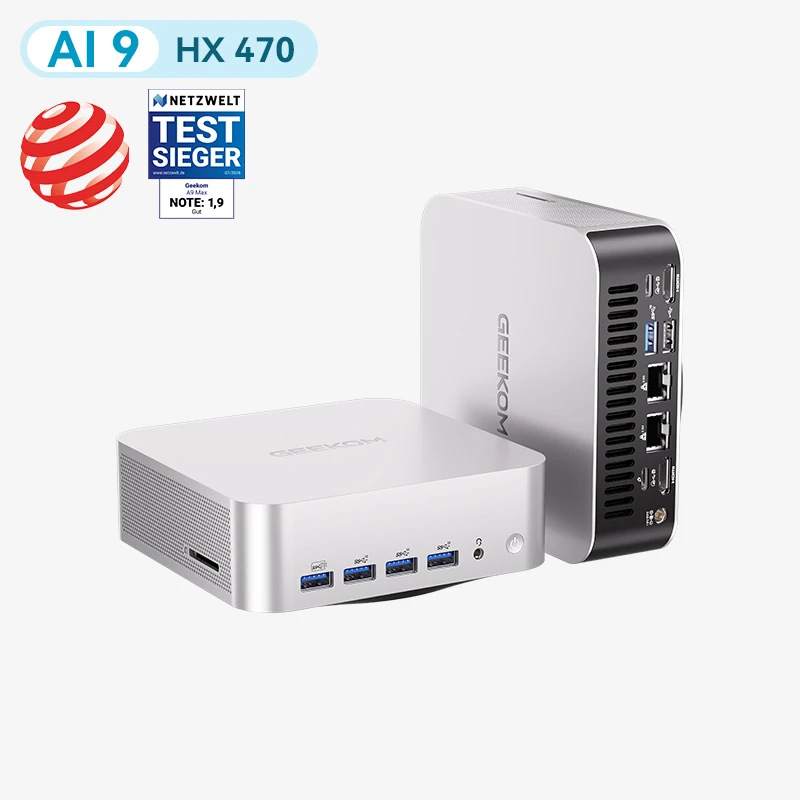
GEEKOM A9 Max mit AMD Ryzen AI 9 HX 470 und Radeon 890M |
32 GB DDR5 ab Werk, aufrüstbar auf bis zu 128 GB |
| 70B, 120B und große MoE-Modelle |
GEEKOM A9 Mega mit AMD Ryzen AI Max+ 395 oder 388 |
64 oder 128 GB LPDDR5X, 256-Bit-Speicherbus |
Beim A9 Max lässt sich der Arbeitsspeicher später erweitern. Beim A9 Mega ist der schnelle LPDDR5X-Speicher fest verbaut – wählen Sie die Speichergröße deshalb gleich beim Kauf passend zu den Modellen, die Sie nutzen möchten. Mehr Praxistipps finden Sie in unserem Ratgeber zum Mini-PC für lokale LLMs.
Häufige Fragen
Kann Unified Memory eine Grafikkarte ersetzen?
Ja, wenn es Ihnen vor allem darum geht, dass ein Modell überhaupt läuft. Unified Memory bietet deutlich mehr Platz als die meisten Grafikkarten. Die Textausgabe ist aber langsamer als auf einer Grafikkarte mit hoher Speicherbandbreite.
Wie viel Speicher braucht ein 70B-Modell?
Ein 70B-Modell mit 4-Bit-Quantisierung belegt rund 40 GB. Planen Sie mindestens 64 GB Speicher ein, damit auch Betriebssystem, Programme und der KV-Cache Platz haben. Mit 128 GB haben Sie genügend Reserve für lange Texte und parallel laufende Anwendungen.
Was ist der Unterschied zwischen RAM und VRAM?
RAM ist der Arbeitsspeicher des Prozessors. VRAM ist der Speicher der Grafikkarte und auf hohe Geschwindigkeit ausgelegt. Bei Unified Memory gibt es diese Trennung nicht: CPU und integrierte Grafik teilen sich einen gemeinsamen Speicher.
Braucht ein langer Chat mehr Speicher als ein kurzer?
Ja. Die Modellgewichte bleiben gleich groß, aber der KV-Cache wächst mit jedem Token im Gespräch. Bei langen Chats oder großen Dokumenten kann das mehrere Gigabyte zusätzlich ausmachen.
Sind Mini-PCs für lokale KI zu Hause schnell genug?
Für eine Person ja: Zusammenfassungen, Programmierhilfe, privater Chat und Dokumentensuche funktionieren gut. In unserem Test erreichte der GEEKOM A9 Mega je nach Modell 11 bis 68 Tokens pro Sekunde. Große Modelle antworten aber langsamer als vergleichbare Modelle auf einer schnellen Grafikkarte.
Kann ein PC Arbeitsspeicher und VRAM gleichzeitig für ein LLM nutzen?
Ja. Programme wie llama.cpp oder Ollama können einen Teil des Modells auf der Grafikkarte und den Rest im Arbeitsspeicher ausführen. Das funktioniert, ist aber deutlich langsamer, weil die Daten über die vergleichsweise langsame Verbindung zwischen CPU und Grafikkarte laufen. Mehr Arbeitsspeicher vergrößert den VRAM einer Grafikkarte nicht.
Fazit: Erst die Kapazität, dann das Tempo
Wählen Sie Unified Memory, wenn der Speicherplatz bestimmt, welche Modelle Sie nutzen können. Wählen Sie dedizierten VRAM, wenn Ihr Modell bereits passt und Sie schnelle, gleichmäßige Antworten für mehrere Nutzer brauchen.
Für die meisten, die KI lokal betreiben möchten, ist Unified Memory der sinnvollere Einstieg: Ein Mini PC mit 64 oder 128 GB gemeinsamem Speicher führt Modelle aus, für die man sonst mehrere Grafikkarten bräuchte – leise, sparsam und auf kleinstem Raum. Prüfen Sie vor dem Kauf, welche Modellgröße Sie nutzen wollen, und rechnen Sie genug Reserve für Betriebssystem und Alltagsprogramme ein.